公众号多账号批量查询阅读数:并发、延时与队列实现
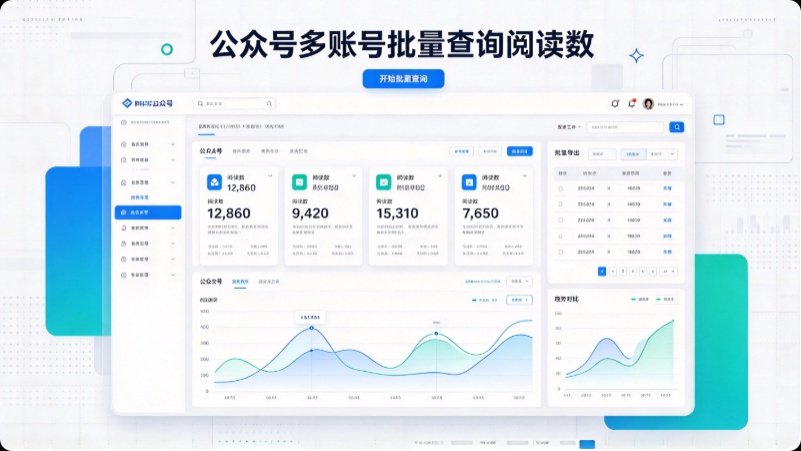
单个账号的阅读数采集与几十上百个账号的批量采集,是两种不同的工程问题。批量场景下最常踩的坑不是接口不可用,而是并发策略把瞬时请求密度推得过高,导致整批任务被频控拖死。本文对应支柱页第五节“批量采集多个账号”,按“队列—并发—延时—防护—落表”的顺序说明一种可落地的实现方式。
一、用队列替代一次性 fan-out
不要一次性把所有待采集 URL 同时发出去。更稳妥的架构是:把 URL 放入队列,由固定数量的 worker 以受控速率消费。队列可以是内存队列、Redis 队列或数据库任务表;worker 数量根据你的配额和实测频控反馈调整,而不是一开始就拉满。这样即使某个账号或某篇文章触发限流,也只影响单个任务,不会拖垮整批。
二、并发控制与主动延时
公开实践中反复出现的建议是:在批量循环中主动加入不低于 10 秒级别的延时,而不是依赖默认并发速率去“试探”平台阈值。延时可以放在每个任务之后,也可以按固定时间窗口做令牌桶限速。阅读数接口的频控通常比评论接口宽松,但如果同一批次混调评论数据,需要为评论请求分配更保守的节奏。限流响应的退避参数可参见公众号 API QPS 限制与指数退避重试策略。
三、连续空数据计数器
批量任务必须加入“连续空数据计数器”:当连续超过一定篇数(例如 10 篇)返回空值时,立即终止脚本并告警,而不是继续重试到配额耗尽。这个逻辑比单纯增加重试次数更能保护账号配额。空数据的具体原因可延伸阅读阅读数接口返回异常值的常见原因。
四、批量结果的落表
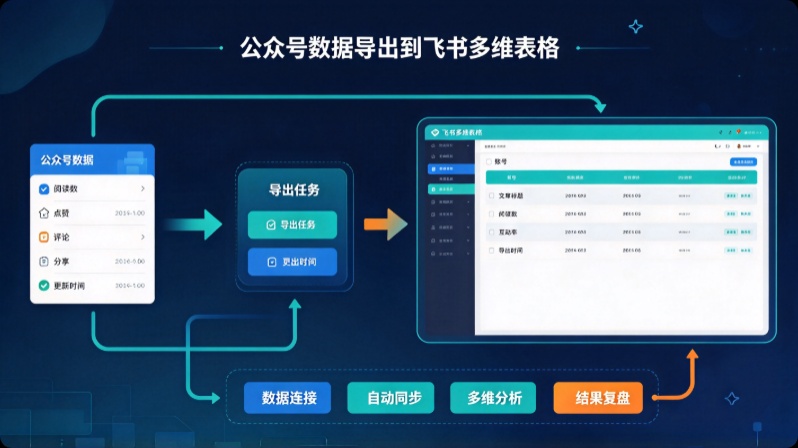
批量采集的结果通常需要落到表格供运营筛选。可以在写入前统一字段命名,保留原始返回值和采集时间戳,再通过飞书多维表格或数据库表展示。字段映射和导出方式可参考公众号数据导出到飞书多维表格。如果你还没有完成单账号接入,建议先回到公众号文章阅读数实时接口完整指南确认请求参数。
FAQ
批量采集 20 个账号,可以一次并发发出去吗?
不建议。一次性 fan-out 容易把瞬时请求密度推过频控阈值。使用队列和固定 worker 更稳。
延时应该设多少?
公开实践建议不低于 10 秒级别的主动延时,具体取决于你的配额和实测频控反馈。不要用“试探阈值”代替受控速率。
批量任务中断后怎么恢复?
队列任务应记录状态,失败任务单独重试,而不是整批重跑。连续空数据时应暂停而不是无限重试。